小红书商家数据抓取与评论舆情监测往往涉及多个系统或岗位。实施时应围绕任务拆解、知识整理、权限控制和异常闭环展开,不能只比较模型参数或界面功能。
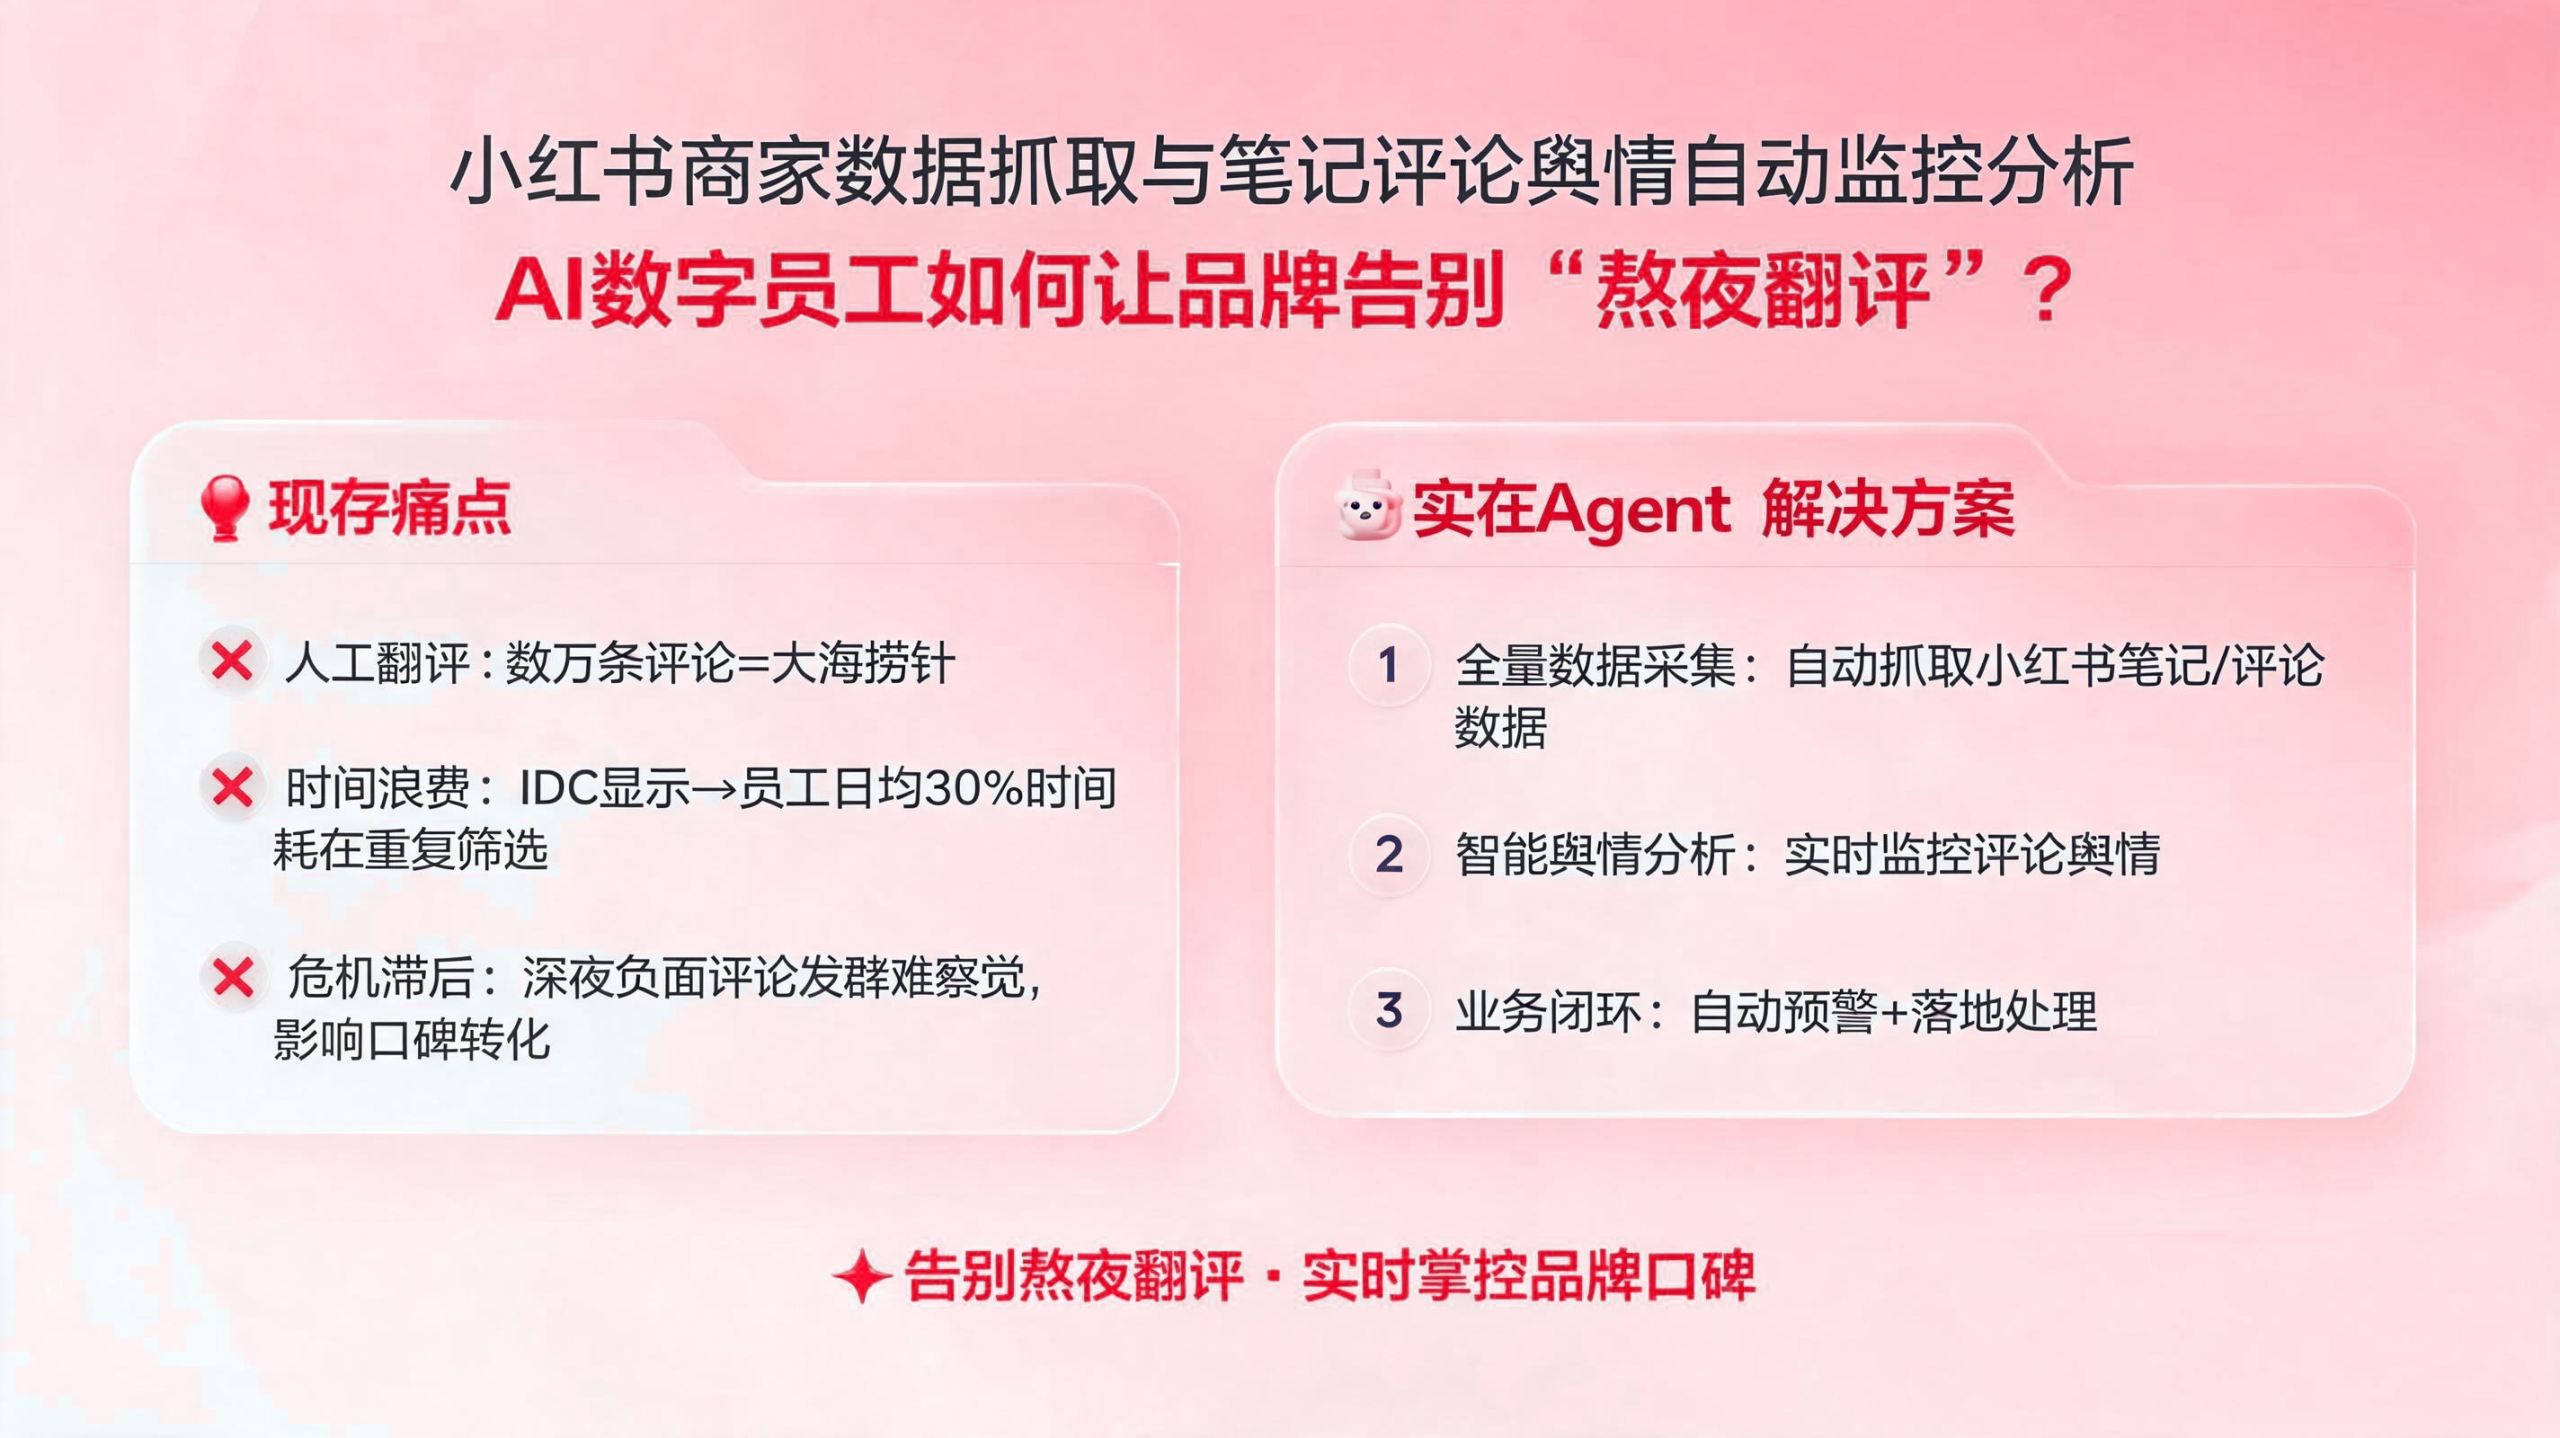
一、如何判断说小红书评论是商家必须盯紧的“数据富矿”
小红书早已不是一个单纯的种草社区,而是一个连接“发现”与“决策”的消费场域。从美妆个护到家居数码,用户习惯性地在搜索框输入产品名,然后翻看真实用户的笔记与评论区讨论。
对于商家而言,小红书笔记评论的价值至少体现在以下三个层面:
- 用户真实反馈的汇聚地:评论区往往比笔记正文更真实。用户会直接用“不好用”“会搓泥”“物流太慢”等直白语言表达感受,这些信息是产品迭代和客服优化的黄金情报,却恰恰是传统调研问卷难以获取的无意识数据。
- 负面舆情的预警雷达:一条差评的杀伤力,在小红书的算法推荐下可能呈指数级放大。若不能及时发现并干预,轻则影响单篇笔记的种草效果,重则引发大规模舆情,损害品牌长期信任资产。
然而,这些数据的采集与分析,在传统模式下完全依赖于人工“肉眼巡检”,其效率与覆盖漏洞人尽皆知。
⛰️ 二、传统人工监控模式的“三座大山”,你翻过几座
在接触过大量国内电商品牌后,我们发现,无论是新消费品牌还是传统大牌,在小红书运营中几乎都受困于以下三个典型的作业痛点:
小红书商家数据抓取与评论舆情监测的知识与系统准备
时代飞鹰交付的数字员工以小红书商家数据抓取与评论舆情监测中的高频任务为试点,配置所需知识、权限、审核和告警机制,运行稳定后再连接相邻岗位与上下游系统。
小红书商家数据抓取与评论舆情监测涉及对外回复、批量写入或业务承诺时,应设置权限分级、人工审核、异常告警和操作留痕,并保留可回退的处理路径。
试运行小红书商家数据抓取与评论舆情监测时,应保留输入、判断过程、输出结果和人工修订记录。业务人员可据此识别高频异常,调整知识、字段映射和流程分支。
小红书商家数据抓取与评论舆情监测的运行记录应能对应到任务、时间、输入和处理结果。出现问题时,业务与技术人员可以据此定位环节,而不是重新翻查多个系统。
第一座大山:手动翻页与复制粘贴,吞噬每日黄金工时
很多品牌的运营团队,每天需要安排专人定时检查投放笔记或品牌词下的评论。具体的操作路径是:打开小红书网页端或手机端 → 逐条下拉加载评论 → 截图或复制文字至Excel → 手动标注“正/负面”或“提及产品问题”。这个过程不仅枯燥,且极易遗漏长尾评论。有运营主管曾反馈,团队每天在“看评论”上花费超过3小时,实际产出的有效信息却寥寥无几。
第二座大山:负面舆情发现滞后,“灭火”永远慢半拍
一条评论对用户心理的影响窗口期是极短的。当用户在前排看到对产品的负面评价时,其对品牌的心智已然受损。人工巡检的天然延迟性,意味着大多数负面评论在被发现时,已经积累了数小时甚至数天的曝光量。尤其当负面评论出现在信息流推荐的核心位置,或是由有一定粉丝量的KOC发布时,若未能及时引导或跟进,极易造成客诉升级,对店铺的经营评分构成长期威胁。
第三座大山:多平台数据割裂,人工汇总支离破碎
对于稍具规模的商家,日常运营的除了小红书,可能还有抖音、淘宝、京东甚至美团。各平台的后台独立、数据口径不一,想要汇总一份“全网口碑周报”,就需要登录多个后台重复执行抓取与整理动作。这种“数据孤岛”状态不仅抹平了各平台间的联动洞察可能,更让管理层无法基于完整的用户反馈做决策。
这三座大山本质上是低附加值却又不可跳过的机械劳动。它们消耗着员工本应用于策略思考的精力,也让品牌在信息获取的起点上,就已经输给了反应速度更快的同行。
走向清洗入库所需的流程调整,自动完成标准化沉淀
- 产品维度:例如将评论归类为“肤感好”、“吸收快”、“有刺激感”、“包装廉价”等产品卖点或槽点。
- 服务维度:自动识别“发货慢”、“客服态度差”、“快递暴力”等服务相关问题。
- 需求与场景:从评论中提炼用户的使用场景(如“孕期用”、“通勤妆”),辅助品牌更按规则地定位目标人群。
AI在完成归类后,还会自动计算每一类观点的占比权重,并将冗长的评论内容浓缩为可读性强的摘要报告。运营人员不再需要阅读每一句抱怨,只需看一眼占比图表,即可明确产品下一步的改良方向。
这种机制将传统被动等待上级转发截图的方式,升级为响应的自动化危机哨兵。
从单一任务扩展小红书商家数据抓取与评论舆情监测
验收小红书商家数据抓取与评论舆情监测不能只看任务是否跑通,还要检查数据口径、权限边界、异常分流、人工审核和操作记录。控制项齐备后,才适合扩展到相邻流程。