判断传统爬虫替代是否适合自动化,需要同时看任务频率、规则稳定性、数据可获得性和错误成本。高频但边界不清的任务,应先补齐规则再进入试点。
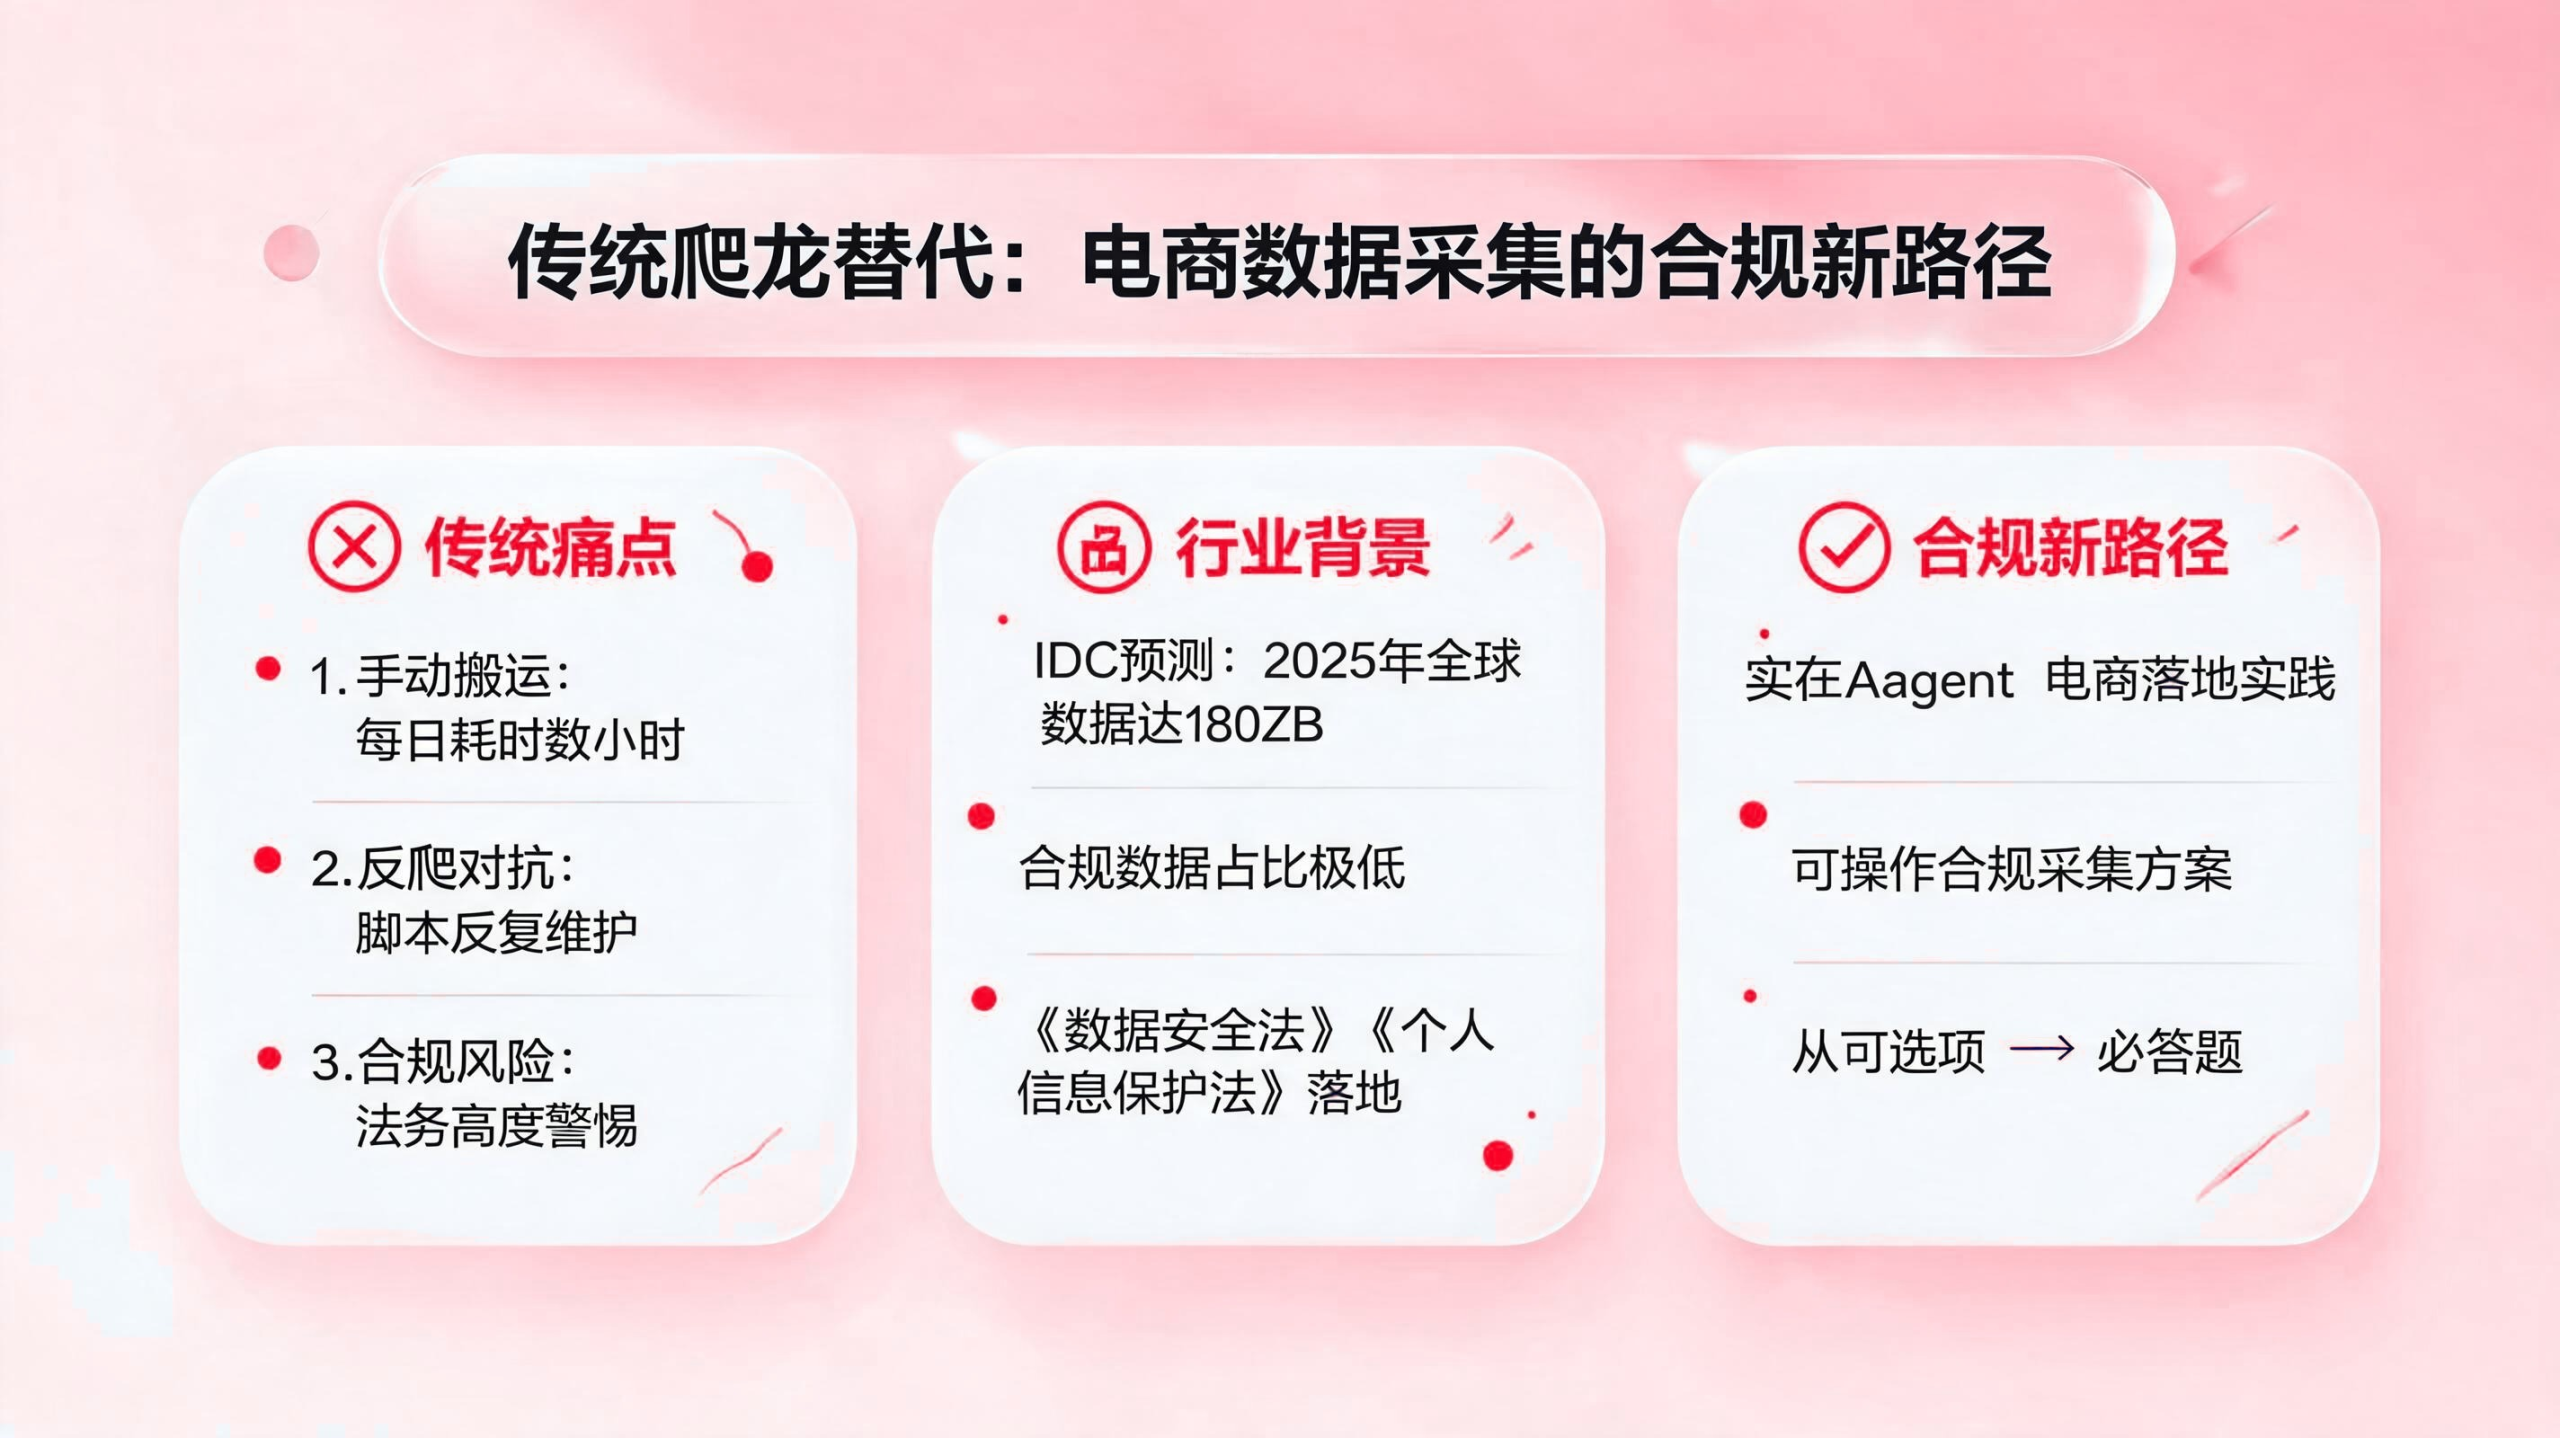
法律合规风险:从灰色地带走向明确红线
过去很多企业认为爬取公开数据“问题不大”,但随着法规体系的完善,这一认知正在被打破。
- 法规约束趋严:《数据安全法》《个人信息保护法》对数据的收集、存储、传输提出了明确要求,未经授权采集个人信息可能面临高额处罚。
- 反不正当竞争风险:大规模、高频次抓取平台数据,可能被认定为破坏他人商业模式,近年相关司法判例并不少见。
- 平台协议限制:几乎所有主流电商平台的用户协议都明确禁止自动化批量抓取,一旦触发风控,企业账号可能被封禁。
法务部门的担忧并非空穴来风。传统爬虫的核心逻辑是“绕过限制、批量获取”,这与当前数据合规的监管方向存在天然张力。企业需要的不是更“隐蔽”的爬虫,而是换一条路径。
围绕传统爬虫替代设计执行链路
围绕传统爬虫替代,时代飞鹰构建的自动化链路优先复用企业已有系统和数据,分别定义读取、判断、写入与通知动作,并为异常情况保留人工处理入口。
传统爬虫替代涉及对外回复、批量写入或业务承诺时,应设置权限分级、人工审核、异常告警和操作留痕,并保留可回退的处理路径。
传统爬虫替代所需的知识内容要按岗位权限开放。制度更新、平台规则变化或业务口径调整后,应由明确责任人完成审核和版本更新。
维护传统爬虫替代时,业务规则和系统连接应分开管理。规则调整由业务负责人确认,连接异常由技术人员处理,减少修改相互影响。
技术对抗成本:猫鼠游戏没有真正的赢家
即便暂时不考虑合规问题,传统爬虫的技术维护成本也在快速攀升。
- 反爬机制持续升级:验证码、行为检测、IP封禁、动态渲染、接口加密等手段不断加码,爬虫脚本的平均失效周期越来越短。
- 维护投入居高不下:页面结构一变,脚本就要重写;平台风控一升级,整套采集链路就可能全线瘫痪。
- 数据断流影响决策:采集不稳定直接导致数据断供,运营和决策部门拿不到及时情报,错失市场机会。
这场“猫鼠游戏”中,企业投入了大量技术资源,却往往换来脆弱且不可持续的数据管道。
数据质量困境:抓得到,不等于用得上
就算技术上跑通了,传统爬虫采集回来的数据也常常难以直接支撑业务。
- 数据口径不统一:不同平台、不同系统的商品编码、门店名称、单位规格千差万别,无法直接汇总分析。
- 清洗工作量巨大:抓回的原始数据需要大量人工比对、换算、映射,业务人员反而被“数据搬运”拖累。
- 缺乏操作留痕:数据从哪来、经过哪些处理、是否可追溯,往往缺乏完整记录,难以应对内审与外部合规检查。
因此,问题的关键不在于“能不能抓到”,而在于“以什么方式抓、抓完能不能用、整个过程是否经得起检验”。
走向数字员工思维所需的流程调整
合规数据采集新路径的核心,是把数据采集从“脚本程序”升级为“数字员工”。二者最本质的区别在于:
- 传统爬虫:绕过平台限制,以非人类行为模式批量请求数据。
模拟真人操作,边界清晰可控
- 操作逻辑合规:模拟人工登录、页面浏览、数据读取,不触发平台反爬机制。
- 行为节奏可控:采集频率、时间窗口、操作路径均可按需配置,避免对目标系统造成压力。
- 全程留痕:每条数据的来源、采集时间、处理过程都有完整日志,方便内审与合规检查。
采集只是起点,标准化映射才是价值放大器
真正解决业务问题的,不只是把数据“拿回来”,而是把数据“变成能用的样子”。
- 自动映射:将不同平台的商品编码、门店名称、规格单位,自动映射为企业内部标准ID。
- 自动换算:完成单位换算与系数折算,输出口径统一的标准化数据。
- 直接可用:业务部门拿到的不再是原始表格,而是可以直接用于分析的决策数据。
- 全天候自动采集:数字员工自动登录70余个异构商超系统,模拟人工操作抓取销售数据,单个系统处理时间压缩至20分钟以内。
传统爬虫替代运行后的迭代重点
传统爬虫替代上线后的重点是持续校准。平台规则、账号权限和岗位分工变化时,知识内容、字段映射和流程分支也要同步更新。